構成の選び方が問われるようになった理由
IPAの「情報セキュリティ10大脅威 2026」(組織編)では、「AIの利用をめぐるサイバーリスク」が初めて3位に入りました。AIに渡したデータの扱いが、組織のリスクとして扱われるようになっています。
一方で、「社外に出せないから完全オンプレミス」と決めてしまうと、精度・費用・運用の手間で後から困ることがあります。データの区分ごとに、置き場所を選ぶのが確実です。
公開 2026.10.31
社外に出せないデータで生成AIを使う構成は、完全オンプレミス、国内リージョンのクラウドに閉域で接続する構成、その組み合わせの3つです。多くの会社は「国内リージョンのクラウド+閉域接続」で要件を満たせます。完全オンプレミスが要るのは、外部と一切つなげない環境や、社外に置けないと決まっているデータがある場合です。データの区分→求める精度→同時に使う人数→運用できる人員の順で決めます。
この記事に関連する資料:AIエージェントに任せる業務の選び方 チェックシート(印刷して書き込める)(入力1分・その場でダウンロード)
IPAの「情報セキュリティ10大脅威 2026」(組織編)では、「AIの利用をめぐるサイバーリスク」が初めて3位に入りました。AIに渡したデータの扱いが、組織のリスクとして扱われるようになっています。
一方で、「社外に出せないから完全オンプレミス」と決めてしまうと、精度・費用・運用の手間で後から困ることがあります。データの区分ごとに、置き場所を選ぶのが確実です。
 無料の資料AIエージェントに任せる業務の選び方 チェックシート(印刷して書き込める)入力1分・その場でダウンロード →
| 完全オンプレミス | 国内リージョンのクラウド+閉域接続 | 組み合わせ | |
|---|---|---|---|
| データの置き場所 | 社内のサーバー・PCだけ | 国内のデータセンター(専用の閉域接続) | 機密のデータは社内、それ以外はクラウド |
| 使えるAIモデル | 公開されているモデル(ローカルLLM) | クラウドの最新のモデルも使える | 用途ごとに使い分け |
| 精度 | 業務を絞って学習させれば高くできる | 汎用の業務で高い | 両方のよいところを取れる |
| 初期の準備 | GPUサーバーなどの用意が要る | 比較的少ない | 中くらい |
| 運用の手間 | モデルの更新・機器の保守が要る | 少ない | 中くらい |
| 向いている例 | 外部と接続できない環境、未公開の設計情報 | 社外秘だが、国内での保管が認められているデータ | 部署やデータの機密度が混在している |
社内の規程を読み直すと、「社外に出してはいけない」ではなく、「国内で保管し、学習に使われず、通信経路が守られていればよい」と定めている会社が少なくありません。この場合は、国内リージョンのクラウドに閉域で接続する構成で要件を満たせ、最新のモデルを使えて、機器の保守も要りません。
完全オンプレミスを選ぶのは、次のような場合です。
GPUに要るメモリは、おおよそ次の3つの合計です。
| 中身 | 計算の仕方 |
|---|---|
| モデルの重み | パラメータ数 × 1パラメータあたりのバイト数(16ビットなら2、8ビットなら1、4ビットなら0.5) |
| 文脈を覚えておく領域(KVキャッシュ) | 1回に扱う文章の長さ × 同時に処理する件数に比例して増える |
| 余裕 | 実行のための作業領域。実機で測って決める |
たとえば300億パラメータのモデルなら、重みだけで16ビットでは約60GB、4ビットに量子化すると約15GBです。量子化すると精度が落ちることがあるため、正解データで量子化の前後を比べてから決めます。
同時に処理する件数は、利用者の総数ではなく、混み合う時間帯の依頼の数で見積もります。1分間に届く依頼の数 × 1件の処理時間(分)が、同時に処理する件数の目安です。1分間に20件届き、1件に30秒かかるなら、同時に約10件です。
最後に、候補の機器で「1秒あたりに出せる文字数」を、同時の件数をかけた状態で実際に測ります。机上の計算だけで機器を決めないことが大切です。
AIエージェントは自分でシステムを操作するため、モデルを社内に置くだけでは足りません。総務省・経済産業省の「AI事業者ガイドライン」第1.2版(2026年3月)も、AIエージェントについての記述を加えています。
ジンベイのローカルLLM・閉域AIの構築では、データの区分を決めるところから始め、3つの構成から要件に合うものを選んで、AIエージェントの権限・承認・記録まで設計します。業務を絞ってモデルを学習させる場合は、ファインチューニングと組み合わせます。
この記事に関連する製品・サービス
ローカルLLM・閉域AIの構築最終更新: 編集:ジンベイ株式会社
受託サービス・情報収集
AIエージェントに任せる業務を、印刷して書き込める6枚のシートで選べる資料です。
PDF 12ページ
資料の内容を見る
受託サービス・情報収集
検図(図面の差分チェック)、図面と仕様書・材料表の突き合わせ、手書き図面の清書を、AIに任せるときの考え方をまとめた資料です。
PDF 14ページ
資料の内容を見る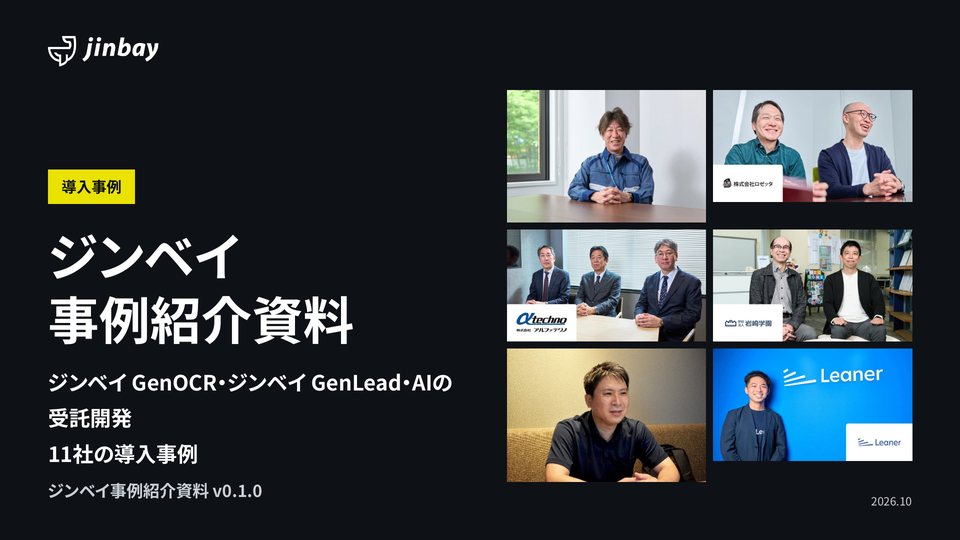
受託サービス・比較検討
AI-OCR「ジンベイ GenOCR」、展示会のリード管理「ジンベイ GenLead」、AIの受託開発・導入支援の導入事例11社を、製品ごとにまとめた資料です。
PDF 15ページ
資料の内容を見る